핵심 이해
이상치는 확인할 관측이지, 곧바로 버릴 관측은 아닙니다
주변 값에서 유난히 떨어진 관측을 발견하면 먼저 비교 기준을 묻습니다. 같은 지역이라도 용도·면적·시점이 다르면 가격 분포가 달라질 수 있습니다. 이상치 후보는 정한 규칙에 따라 추가 확인 대상으로 표시한 관측입니다. 표시만으로 입력 오류나 부적정 거래가 입증되지는 않습니다.
이 장에서는 05장의 사분위수로 울타리를 계산하고, 배수·집단·계산 관례에 따라 판정이 달라질 수 있음을 살펴봅니다. 이어서 포함·제외 결과를 비교하고 처리 근거를 남기는 방법을 익힙니다.
울타리 계산
Q1과 Q3에서 IQR의 일정 배수만큼 넓힙니다
IQR=Q3−Q1은 가운데 부분의 퍼짐입니다. 배수 k를 정하면 하한 L=Q1−k×IQR, 상한 U=Q3+k×IQR입니다. 이 장에서는 x<L 또는 x>U인 값을 후보로 표시하고, 경계와 같은 값은 포함합니다. 수염은 울타리 자체가 아니라 그 안에 있는 실제 관측값까지 그립니다.
공통 학습 예시 30건은 Q1=98, Q3=168, IQR=70입니다. k=1.5이면 L=98−105=−7, U=168+105=273입니다. 최솟값 62는 하한보다 크고, 24번 268은 상한보다 5 작습니다. 따라서 7번 480만 후보입니다. 음수 하한은 계산 결과이며 음수 거래가 존재한다는 뜻이 아닙니다.
1.5배는 널리 쓰이는 탐색 규칙이며 3배 울타리도 함께 쓰입니다. k가 2여야 한다는 통계학적 의무는 없습니다. 배수는 민감도를 정하는 선택이고, 울타리가 95% 신뢰구간이거나 잘못된 거래를 확률 95%로 검출한다는 의미도 아닙니다.
자료와 사분위수를 고정하면 k를 키울수록 경계가 바깥으로 이동합니다. 후보 수는 줄거나 그대로이며 늘지 않습니다. 이 예제에서는 273과 378 사이에 값이 없어 세 배수 모두 1건입니다. 필터 적용 후 사분위수를 다시 구하는 절차는 이 비교와 다릅니다.
계산 관례와 예외
작은 표본과 같은 값이 많은 자료에서는 더 주의합니다
이 장은 정렬한 자료를 절반으로 나누어 각 절반의 중앙값을 Q1·Q3로 삼고, 홀수 건수에서는 전체 중앙값을 양쪽 절반에서 제외합니다. 분위수 계산 관례에 따라 경계는 달라질 수 있습니다. 공통 30건에 선형 보간 type 7을 쓰면 Q1=99, Q3=166, IQR=67이며 1.5배 울타리는 −1.5와 266.5입니다. 이때는 268과 480 두 건이 후보가 됩니다.
표본이 작으면 몇 개 관측이 사분위수 위치를 크게 바꿉니다. 반올림된 값이나 동일 값이 많아 IQR=0이면 두 울타리가 Q1=Q3로 겹칩니다. 예를 들어 100·100·100·100·100·100·120은 이 관례에서 IQR=0이고 120만 경계 밖입니다. 그것만으로 120이 오류라고 결론 내리지 않습니다.
제외 후 울타리를 다시 계산해 반복 적용하면 처음에는 포함되던 값도 나중에 빠질 수 있습니다. 한 번 계산한 경계를 쓰는지, 반복하는지 구분하고 기록해야 합니다. 결과가 원하는 모양이 될 때까지 배수를 바꾸지 않습니다.
집단과 분포
누구와 비교하느냐가 이상치 판단의 일부입니다
전체 거래에 하나의 기준을 적용하는 것과 용도별로 나누어 적용하는 것은 서로 다른 질문입니다. 전자는 전체에서 떨어진 값을 찾고, 후자는 같은 유형 안에서 떨어진 값을 찾습니다. 집단을 나누면 건수와 사분위수도 다시 구합니다.
이 그림에서는 주거 15건의 IQR은 32, 상업 15건의 IQR은 111입니다. 전체 IQR 70을 두 집단에 그대로 적용하지 않습니다. 집단을 지나치게 잘게 나누면 표본이 작아져 기준이 불안정해질 수 있으므로, 분석 목적에 맞는 비교 집단을 먼저 정합니다.
IQR 울타리를 계산하는 데 정규분포 가정은 필요하지 않습니다. 다만 오른쪽 꼬리가 긴 자료에서 경계 밖의 값이 자연스럽게 나타날 수 있고, 여러 집단이 섞이면 구조적인 차이를 후보로 표시할 수 있습니다. 히스토그램과 산점도를 함께 읽으세요. 한 변수의 IQR 검사는 변수들의 관계에서만 드러나는 특이한 관측까지 모두 찾아내지는 못합니다.
포함·제외 비교
숫자가 얼마나 바뀌는지와 그 이유를 함께 봅니다
공통 예제는 실제 거래 출처가 확인되지 않은 학습 자료입니다. 7번을 제외하면 평균은 146.33에서 134.83, 중앙값은 122에서 120으로 바뀝니다. 06장 표준편차는 80.16에서 51.72로 줄어듭니다.
평균과 표준편차가 더 크게 변하는 것은 큰 관측의 영향과 연결됩니다. 중앙값과 IQR은 꼬리의 일부 값에 상대적으로 덜 민감하지만, 어떤 변경에도 불변인 지표는 아닙니다. 전체 시장을 묻는 분석에서 유효한 고가 거래를 빼면 분석 대상 자체가 달라질 수 있습니다.
확인과 처리
원자료를 확인하고 처리 근거를 남깁니다
- 대상을 정합니다. 지역·기간·유형, 관측 단위, 금액인지 단가인지와 단위를 확인합니다.
- 후보를 표시합니다. 사분위수 산식, k, 경계 포함 여부, 기준 건수와 후보 목록을 남깁니다.
- 원자료를 대조합니다. 단위 입력, 면적 분모, 중복, 정정 여부와 거래 조건을 확인합니다. 높은 단가만으로 원인을 추측하지 않습니다.
- 처리 방식을 선택합니다. 확인된 오류는 근거에 따라 정정하고, 유효한 별도 집단은 구분해 분석할 수 있습니다. 근거가 부족하면 원자료를 유지한 결과와 민감도 비교를 함께 제시합니다.
- 변경을 설명합니다. 제외 사유·건수와 전후 통계량을 보고합니다. 원자료는 보존합니다.
절사(trimming)는 일부 관측을 분석에서 제외하고, 윈저화(winsorization)는 정한 경계값으로 극단의 값을 바꾸는 방식입니다. 둘은 건수와 분포에 미치는 효과가 다릅니다. 어느 방식도 자동으로 오류를 교정해 주는 것은 아니며, 적용했다면 규칙을 밝혀야 합니다.
확인 문제
판정 기준과 처리 결정을 구분해 보세요
- Q1=98, Q3=168, k=1.5일 때 273은 후보인가요?
답과 해설
아니요. 상한은 273이며 이 장은 경계를 포함합니다. 273보다 큰 값이 위쪽 후보입니다. 실제 공통 자료에는 273이 없습니다.
- k를 1.5에서 3으로 바꾸면 후보가 반드시 줄어드나요?
답과 해설
반드시 줄지는 않습니다. 같은 자료와 사분위수에서는 줄거나 그대로입니다. 공통 예제는 두 경우 모두 480 한 건입니다.
- 같은 30건인데 한 프로그램은 480만, 다른 프로그램은 268과 480을 표시합니다. 반드시 구현 오류인가요?
답과 해설
아니요. 절반의 중앙값 방식과 type 7은 상한이 각각 273과 266.5입니다. 먼저 분위수 산식과 경계 처리, 비교 집단을 확인해야 합니다.
CH2 Macro에서 읽기
필터 전후의 건수와 기준을 함께 확인합니다
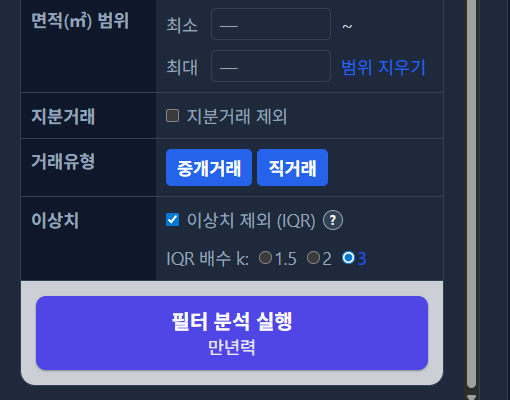
CH2 Macro에서 IQR 옵션을 사용할 때는 적용 변수와 비교 집단, 선택 배수, 적용 전후 건수를 함께 확인하세요. 이 장의 손계산 관례를 서비스의 모든 화면에 그대로 대입하지 말고 해당 화면의 산식 설명을 확인합니다. 필터로 제외했다는 것은 분석 대상에서 빠졌다는 뜻이며 원자료 오류가 확정되었다는 뜻은 아닙니다.
정리와 참고자료
표시 → 확인 → 비교 → 기록 순서로 읽습니다
IQR 울타리는 검토 대상을 찾는 탐색 도구입니다. 배수와 분위수 관례, 비교 집단을 명시하고 후보의 실제 맥락을 확인하세요. 제외 여부는 통계량을 작게 만드는 방향이 아니라 분석 목적과 자료 근거로 판단합니다.
다음 08장 「확률의 기초와 조건부확률」에서는 사건과 확률, 조건에 따른 분모의 변화를 배웁니다.
- NIST/SEMATECH: Box Plot — 상자그림과 IQR 울타리.
- NIST/SEMATECH: Detection of Outliers — 후보 표시와 확인, 처리의 구분.
본문과 그림은 공통 학습 자료 및 별도 가상 예제를 바탕으로 직접 작성했습니다. 출처 미확인 자료를 실제 시장 통계로 해석하지 않습니다. 참고자료 확인: 2026-10-07.