핵심 이해
대표값을 고르기 전에 질문을 정합니다
평균과 중앙값은 자료의 중심을 나타내지만 서로 다른 질문에 답합니다. 평균은 모든 값을 같은 비중으로 합쳐 나눈 크기이고, 중앙값은 값을 정렬했을 때 가운데 위치의 크기입니다. 어느 하나가 언제나 더 정확한 대표값인 것은 아닙니다.
이 장에서는 두 값을 직접 계산하고, 극단값에 대한 반응과 가중치에 따른 해석 차이를 비교합니다. 선수 개념은 변수와 단위, 분포의 모양입니다.
공통 예제
30건의 중심을 두 방식으로 계산합니다
앞 장과 같은 공통 학습 예시 30건의 단가를 사용합니다. 단위는 만원/㎡이며 합계는 4,390입니다. 실제 거래 원천은 확인되지 않았으므로 실제 지역의 시장 수준을 나타내는 자료로 해석하지 않습니다. 원자료 표와 JSON 자료에서 값을 확인할 수 있습니다.
이 장의 그림 1·2는 이 원자료를 그대로 사용합니다. 그림 3은 7번 값만 바꾸는 민감도 예제이고, 그림 4·5는 가중치의 의미를 분명히 보여 주기 위해 별도로 만든 가상 자료입니다. 계산에는 반올림 전 값을 사용하고 표시할 때 필요한 자릿수로 반올림합니다.
산술평균
모든 값이 같은 비중으로 계산에 들어갑니다
산술평균(arithmetic mean)은 값들의 합을 관측 수로 나눈 값입니다. x̄ = (x₁ + x₂ + … + xₙ) ÷ n으로 씁니다. xᵢ는 i번째 관측값, n은 관측 수이며, x̄는 표본평균을 나타냅니다.
공통 예제에서는 x̄ = 4,390÷30 = 146.333…이므로 소수 첫째 자리까지 표시하면 146.3만원/㎡입니다. 이때 4,390은 단가들을 더한 값이며 전체 거래금액이 아닙니다. 전체 금액을 구하려면 각 거래의 면적과 가격 정의를 함께 알아야 합니다.
평균에서 각 값이 차지하는 비중은 1/30입니다. 어느 한 값만 30만큼 커지면 평균은 1만큼 커집니다. 모든 관측이 결과에 반영된다는 장점과, 아주 큰 값이 평균을 움직일 수 있다는 성질은 같은 계산식에서 나옵니다.
평균이 자료를 절반으로 나누는 것은 아닙니다. 이 예제에서 평균보다 큰 값은 10건이고 나머지 20건은 평균보다 작습니다. 따라서 ‘평균보다 낮다’는 말이 곧 ‘하위 절반’이라는 뜻은 아닙니다.
중앙값
정렬한 뒤 가운데 위치를 찾습니다
중앙값(median)은 값을 작은 순서대로 정렬한 뒤 가운데에서 구합니다. 관측 수가 홀수이면 (n+1)/2번째 값, 짝수이면 n/2번째와 그 다음 값의 산술평균을 사용합니다. ‘중위값’도 같은 뜻으로 사용합니다.
30건에서는 15번째 120과 16번째 124를 평균해 122만원/㎡를 얻습니다. 15.5는 가운데 위치를 표현한 수이고 단가가 아닙니다. 가운데 두 값이 같다면 중앙값도 그 값이 됩니다.
중앙값 이하와 이상에는 각각 적어도 절반의 관측이 놓입니다. 같은 값이 반복되면 ‘엄격히 작은 값’과 ‘엄격히 큰 값’이 정확히 절반씩이라는 설명은 맞지 않을 수 있습니다. 중앙값은 최솟값과 최댓값의 평균도 아닙니다. 이 자료의 양 끝을 평균한 (62+480)÷2=271은 다른 지표입니다.
극단값과 민감도
평균과 중앙값은 같은 변화에 다르게 반응합니다
다른 29건을 그대로 두고 7번의 단가만 바꾸어 보겠습니다. 관측 수는 30건으로 유지합니다. 큰 값이 더 커질 때 평균은 움직이지만, 정렬의 가운데 두 값이 그대로이면 중앙값도 그대로입니다.
7번이 480에서 900으로 420만큼 커지면 평균은 420÷30=14만큼 증가해 약 160.3이 됩니다. 중앙의 120·124는 변하지 않으므로 중앙값은 122입니다. 이런 성질 때문에 중앙값은 극단값에 비교적 덜 민감한 중심 지표라고 합니다.
값을 바꾸는 것과 관측을 제외하는 것도 구분해야 합니다. 7번을 제외하면 합계 3,910을 29로 나누어 평균은 약 134.8이 되고, 29건의 가운데인 15번째 값 120이 중앙값이 됩니다. 중앙값이 언제나 변하지 않는다는 뜻은 아닙니다.
가중평균
거래 한 건과 면적 한 단위는 다른 비중입니다
가중평균은 관측마다 비중을 다르게 주는 평균입니다. Σwᵢxᵢ ÷ Σwᵢ로 계산하며, 여기서 wᵢ는 음수가 아닌 가중치이고 합은 0보다 커야 합니다. 모든 가중치가 같으면 산술평균과 같습니다. 기호 Σ는 해당 항들을 모두 더한다는 뜻입니다.
가상 거래 A는 10㎡에 단가 200만원/㎡, B는 90㎡에 단가 100만원/㎡라고 합시다. 두 거래의 금액을 각각 면적×단가로 정의하면 A는 2,000만원, B는 9,000만원입니다.
거래별 단가의 평균은 (200+100)÷2=150만원/㎡입니다. 한 거래마다 같은 비중을 줍니다. 전체 금액÷전체 면적은 (2,000+9,000)÷(10+90)=110만원/㎡입니다. 이는 (10×200+90×100)÷100으로, 면적을 가중치로 둔 단가 평균과 같습니다.
150과 110 중 하나가 계산 오류인 것은 아닙니다. 무엇에 같은 비중을 주었는지가 다릅니다. ‘평균단가’라고만 표시하면 이 차이가 숨겨지므로 산식과 단위를 함께 확인해야 합니다. 면적의 정의가 서로 다르거나 금액과 면적의 대응이 맞지 않으면 위 등식을 그대로 적용할 수 없습니다.
평균의 평균
집단 크기를 무시하면 다른 질문에 답하게 됩니다
서로 중복되지 않는 A집단 10건의 평균 단가가 100이고, B집단 90건의 평균 단가가 200이라고 합시다. 두 집단의 단위와 변수 정의는 같습니다. 전체 평균을 구하려면 집단별 합계로 되돌려 합친 다음 전체 건수로 나눕니다.
전체 평균은 (10×100+90×200)÷100=190입니다. 집단 평균 두 개를 단순 평균한 (100+200)÷2=150은 두 집단을 같은 비중으로 본 평균입니다. 전체 100건에 같은 비중을 준 값과는 다릅니다.
집단 크기가 같다면 집단 평균의 단순평균과 전체 평균이 일치합니다. 반면 중앙값은 집단의 중앙값과 건수만으로 일반적으로 결합할 수 없습니다. 전체 중앙값을 찾으려면 관측값의 정렬 정보가 추가로 필요합니다.
기간별로 이런 집단의 비중이 달라지면 각 집단 내부의 단가가 같아도 전체 평균은 바뀔 수 있습니다. 전체 평균의 변화를 바로 동일 물건의 가격 변화로 읽지 말고, 거래 구성도 함께 살펴보세요.
대표값 선택
중심 하나로 분포 전체를 설명하지 않습니다
전체 합과 연결되는 평균 수준이 필요하면 산술평균이 유용합니다. 정렬했을 때 중간에 놓인 값을 알고 싶거나 큰 관측에 덜 민감한 중심을 보고 싶으면 중앙값이 유용합니다. 가능하면 두 값과 건수·분포를 함께 읽으면 좋습니다.
공통 예제의 평균 146.3이 중앙값 122보다 높다는 사실은 큰 값 쪽 관측의 영향을 살펴보게 합니다. 그러나 두 값의 대소만으로 분포의 모양이나 이상치 여부를 확정할 수는 없습니다. 앞 장의 히스토그램과 산점도를 함께 확인합니다.
중심이 같아도 퍼짐은 다를 수 있습니다. 100·100·100과 0·100·200은 평균과 중앙값이 모두 100이지만 값들이 놓인 범위는 다릅니다. 두 지표만으로 거래의 대부분이 100 근처에 있다고 판단해서는 안 됩니다.
절사평균·최빈값과 평균의 성질
절사평균은 정렬 자료의 양 끝에서 정해진 비율을 제외한 뒤 평균을 구합니다. 어느 비율과 규칙을 썼는지 밝혀야 하며 임의로 불편한 관측만 지우는 방식과 구별합니다. 최빈값은 가장 자주 나타난 값으로, 여러 개일 수 있습니다. 연속형 자료에서 모든 관측값이 다르면 유일한 최빈값을 정하기 어렵고 구간 선택에 따라 가장 높은 히스토그램 막대가 달라질 수 있습니다.
산술평균을 기준으로 한 편차의 합은 0입니다. 또한 편차제곱의 합이 가장 작아지는 중심은 평균이며, 절대편차의 합을 가장 작게 하는 중심은 중앙값입니다. 짝수 자료에서는 가운데 두 값 사이의 모든 값이 절대편차합을 최소화하며, 보통 그 두 값의 평균을 중앙값으로 정합니다. 이 차이는 나중에 오차와 회귀를 이해할 때 다시 사용합니다.
확인 문제
비중과 위치를 구별해 계산해 보세요
- 공통 예제에서 7번을 480에서 780으로 바꾸고 나머지는 그대로 두었습니다. 평균과 중앙값은 어떻게 될까요?
답과 해설
합계가 300 증가하고 건수는 30이므로 평균은 10 증가해 약 156.3입니다. 정렬의 가운데 값 120·124는 그대로라 중앙값은 122입니다.
- 10건 평균 100과 90건 평균 200을 합친 전체 평균을 150이라고 써도 될까요?
답과 해설
전체 거래를 같은 비중으로 본 평균은 190입니다. 150은 두 집단의 평균에 같은 비중을 준 값입니다. 어느 단위에 같은 비중을 주는지 밝혀야 합니다.
- 100·100·100과 0·100·200의 평균·중앙값이 같다면 같은 분포일까요?
답과 해설
아니요. 평균과 중앙값은 모두 100이지만 두 번째 자료의 퍼짐이 더 큽니다. 중심 외에도 분위수·표준편차나 그래프로 분포를 함께 확인해야 합니다.
CH2 Macro에서 읽기
평균·중위를 비교할 때 계산 대상도 확인합니다
CH2 Macro 토지 기본통계에는 평균과 중위 등 단가 요약이 있습니다. 두 수치를 읽을 때는 선택한 지역·기간·유형·건수와 단위를 함께 확인합니다. 화면의 산식 설명을 통해 거래별 단가 평균인지 다른 가중 방식인지 확인해야 합니다.
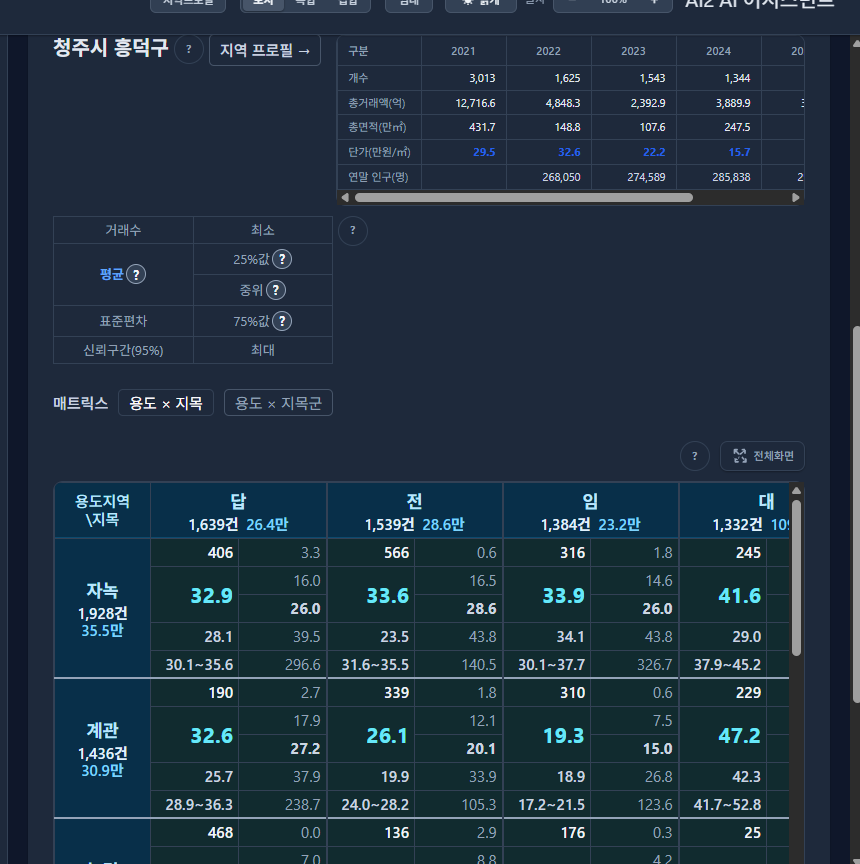
평균과 중위의 차이가 크면 분포와 대상 구성을 추가로 살펴볼 이유가 됩니다. 특정 물건의 적정가격이나 매수·매도 판단을 이 차이만으로 정하지 않습니다.
정리와 참고자료
평균은 비중을, 중앙값은 정렬 위치를 묻습니다
산술평균은 모든 값에 같은 비중을 주며, 중앙값은 정렬한 가운데 위치를 요약합니다. 큰 값의 변화에 대한 반응이 다르고, 집단을 합치거나 단가를 평균할 때는 가중치가 무엇인지가 중요합니다. 어떤 대표값이든 건수와 분포를 함께 읽습니다.
다음 05장 「분위수와 상자그림」에서는 가운데 한 지점을 넘어 자료의 여러 위치를 요약하는 방법을 살펴봅니다.
- NIST/SEMATECH e-Handbook: Measures of Location — 평균·중앙값·최빈값과 극단값 민감도.
- OpenStax, Introductory Statistics 2e §2.5 — 중심 지표의 정의와 계산.
본문과 그림은 이 과정의 예제에 맞춰 새로 작성했습니다. 원자료와 별도 가상 예제의 범위를 각 그림에 표시했습니다. 참고자료 확인: 2026-10-07.